پژوهشی که ۲۲ اوت ۲۰۲۶ در Journal of Behavioral Medicine منتشر شد، امکان استفاده از یک مدل زبانی بزرگِ محلی برای تحلیل روایتهای کوتاه تروما را آزموده است. هدف پژوهشگران این نبود که یک «درمانگر هوش مصنوعی» بسازند؛ آنها میخواستند ببینند آیا مدلی که روی زیرساخت محلی اجرا میشود میتواند نوع مواجهه آسیبزا را از متن آزاد استخراج و به زمینهمندکردن علائم اختلال استرس پس از سانحه کمک کند.
مدل چه کاری انجام داد؟
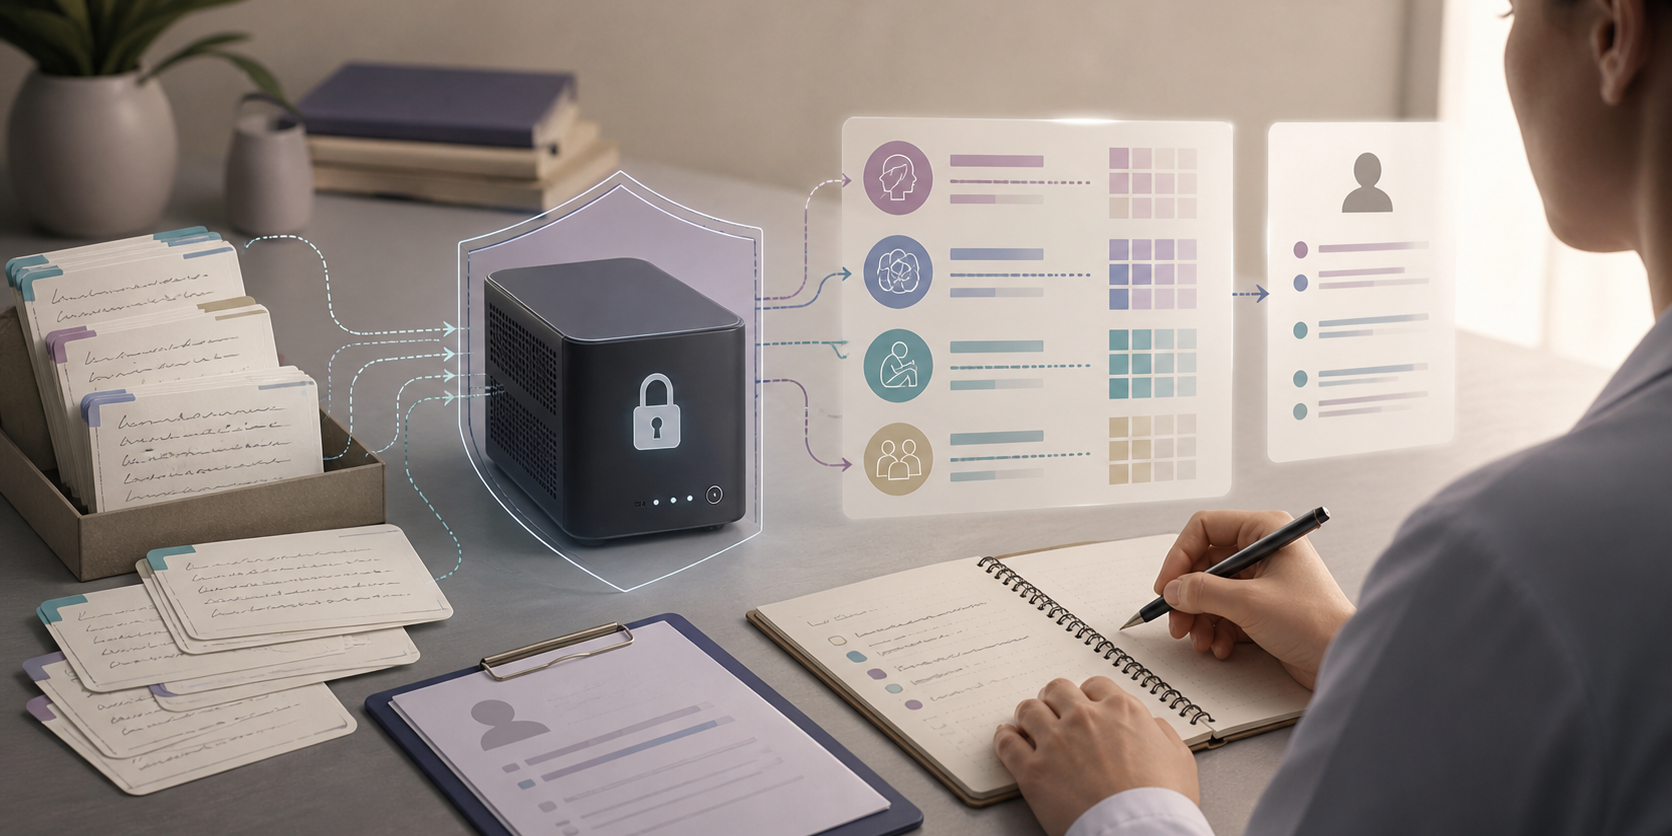
۱۰۹ مشارکتکننده که بهصورت آنلاین از Prolific جذب شده بودند، نسخه گسترشیافته فهرست رویدادهای زندگی را تکمیل کردند و میتوانستند تا سه شرح آزاد از تجربههای آسیبزا بنویسند. آنها همچنین پرسشنامه PCL-5 برای سنجش نشانههای PTSD را پاسخ دادند. مدل زبانی محلی با یک دستور مشخص، نوع تروما را از روایتها استخراج کرد و خروجی آن با دستهبندی دو روانشناس بالینی خبره مقایسه شد.
توافق مدل در همه دستهها یکسان نبود. طبق چکیده مقاله، ویژگی مدل برای بیشتر انواع تروما بالاتر از ۸۵ درصد بود؛ یعنی در بسیاری از مواردی که یک نوع تروما وجود نداشت، مدل آن را بهدرستی غایب تشخیص داد. برای تجربههای پرتکرارتر، مانند تعرض جنسی، توافق با ارزیابان انسانی قویتر بود و ضریب کاپا بین ۰٫۶۸ تا ۰٫۷۴ گزارش شد. پژوهشگران همچنین با استفاده از ویژگیهای استخراجشده خوشههایی ساختند که میانگین نمره کل PCL-5 آنها تفاوت آماری داشت.
چرا «محلی» بودن مهم است؟
در این مطالعه، مدل بهجای ارسال متنهای حساس به یک سرویس ابری عمومی، در محیط محلی اجرا شد. این معماری میتواند کنترل بیشتری بر دادههای بسیار حساس تروما فراهم کند، اما محلیبودن بهتنهایی تضمین امنیت یا محرمانگی نیست؛ شیوه ذخیرهسازی، دسترسی، حذف داده و ممیزی سامانه همچنان اهمیت دارد. مؤلفه AI در این خبر کاملاً مرکزی است، زیرا استخراج خودکار اطلاعات بالینی از روایت آزاد همان متغیری است که با قضاوت متخصصان مقایسه شده است.
نتیجه باید مقدماتی تلقی شود. نمونه کوچک و آنلاین بود، مدل فقط روی روایتهای کوتاه و خودگزارشدهی آزموده شد و PCL-5 جای مصاحبه تشخیصی کامل را نمیگیرد. ویژگی بالا نیز چیزی درباره حساسیتِ همه دستهها نمیگوید؛ ممکن است مدل برخی تجربههای موجود را از دست بدهد. این پژوهش اعتبارسنجی بالینی گسترده، مقایسه بین فرهنگها و زبانها یا آمادگی برای استفاده مستقل در غربالگری را ثابت نکرده است.
بنابراین کاربرد قابلدفاع فعلی، کمک پژوهشی یا پشتیبانی محدود از مرور دادهها زیر نظر متخصص است، نه تشخیص خودکار PTSD. پیش از استفاده واقعی، ارزیابی روی نمونههای بزرگتر و متنوعتر و همچنین سنجش خطاهای پرهزینه، سوگیری و حریم خصوصی ضروری است.
منبع: Rubin و همکاران، Testing the use of local large language models to extract trauma identification and contextualize posttraumatic stress symptoms from self-report، منتشرشده در ۲۲ اوت ۲۰۲۶؛ رکورد PubMed و صفحه DOI.